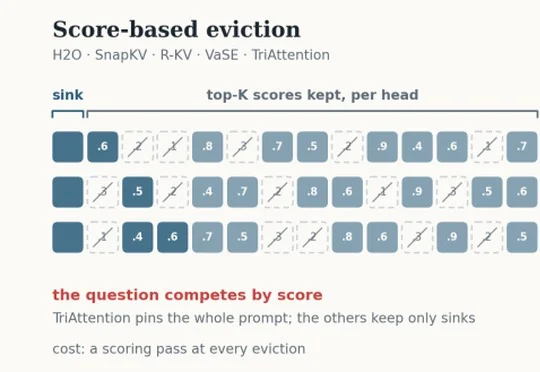
KV Cache不用「精挑细选」?随机删除媲美最强基线,推理吞吐最高再提43%
KV Cache不用「精挑细选」?随机删除媲美最强基线,推理吞吐最高再提43%大模型越来越会 “想”,也越来越能把 GPU 显存 “想满”。 在数学、科学问答和代码生成等任务中,reasoning model 往往会生成数千乃至数万 token 的长推理链。随着生成持续进行,每
来自主题: AI技术研报
8344 点击 2026-09-20 11:05

 搜索
大模型越来越会 “想”,也越来越能把 GPU 显存 “想满”。 在数学、科学问答和代码生成等任务中,reasoning model 往往会生成数千乃至数万 token 的长推理链。随着生成持续进行,每
拿Agent做Coding,想必大家都已经很熟悉了。

趋境科技通过部署SGLang HiCache+Mooncake Store,将KV Cache从单机资源升级为集群级共享池化资源,支撑其日均产出超万亿Token的生产实践,KV Cache命中率稳定突破90%,并在生产环境中持续优化大规模推理集群的性能与稳定性。

过去几年,大模型推理系统优化的核心目标一直围绕一个问题展开:如何让 GPU 更高效地计算权重、激活、KV Cache 等高维张量?从并行策略、请求调度、显存管理到算子优化,学界业界大量优化技术不断提升模型推理效率。
随着AI Coding、Agent、Deep Research 等应用快速普及,模型单次处理的上下文长度正在从几万Token迈向几十万甚至百万Token。
长上下文模型越来越能“记”,但真正让它们跑到线上时,最先顶不住的往往不是算力,而是KV Cache。
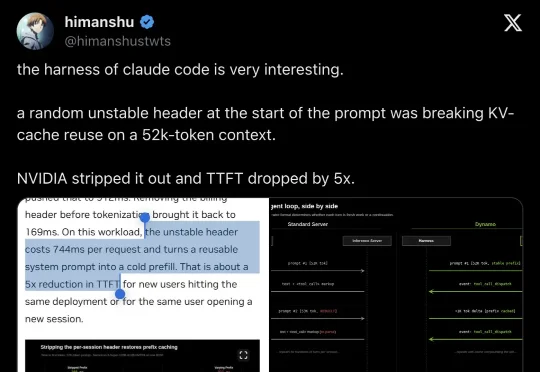
NVIDIA Dynamo 团队发现,Claude Code 向自定义端点发送请求时,prompt 最前面会带一行 session-specific billing header。这行 header 每个 session 都变,导致 52K token 的稳定前缀在 KV cache 中无法复用——TTFT 从 168ms 飙到 912ms。Dynamo 加了一个 `
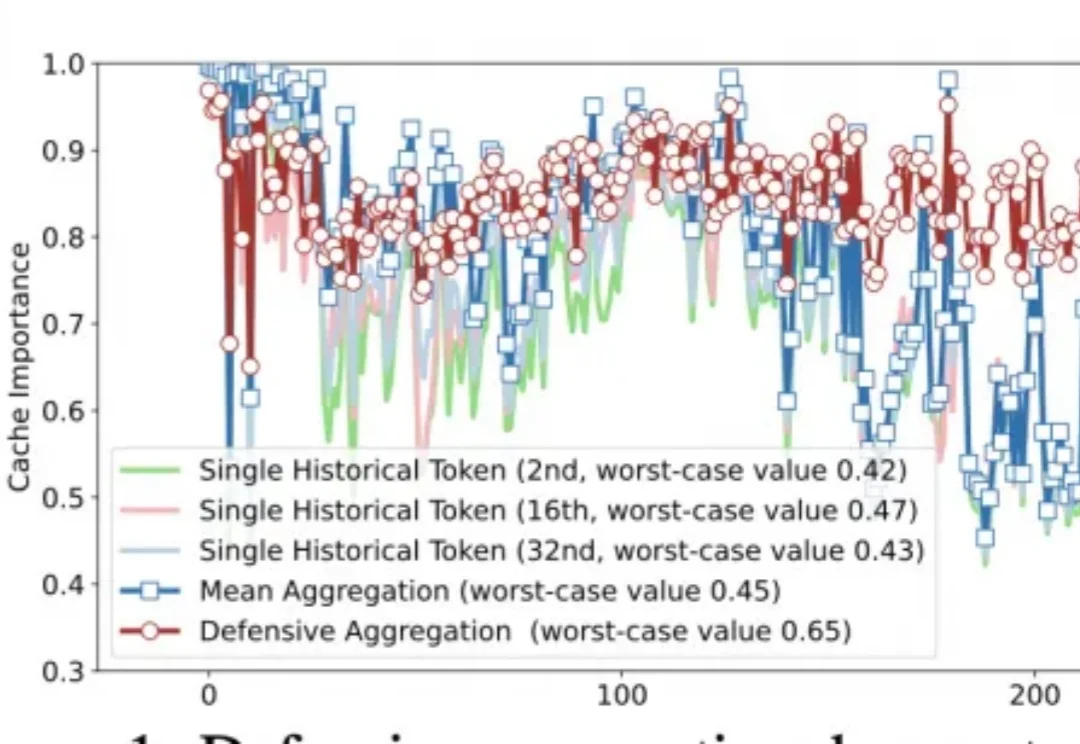
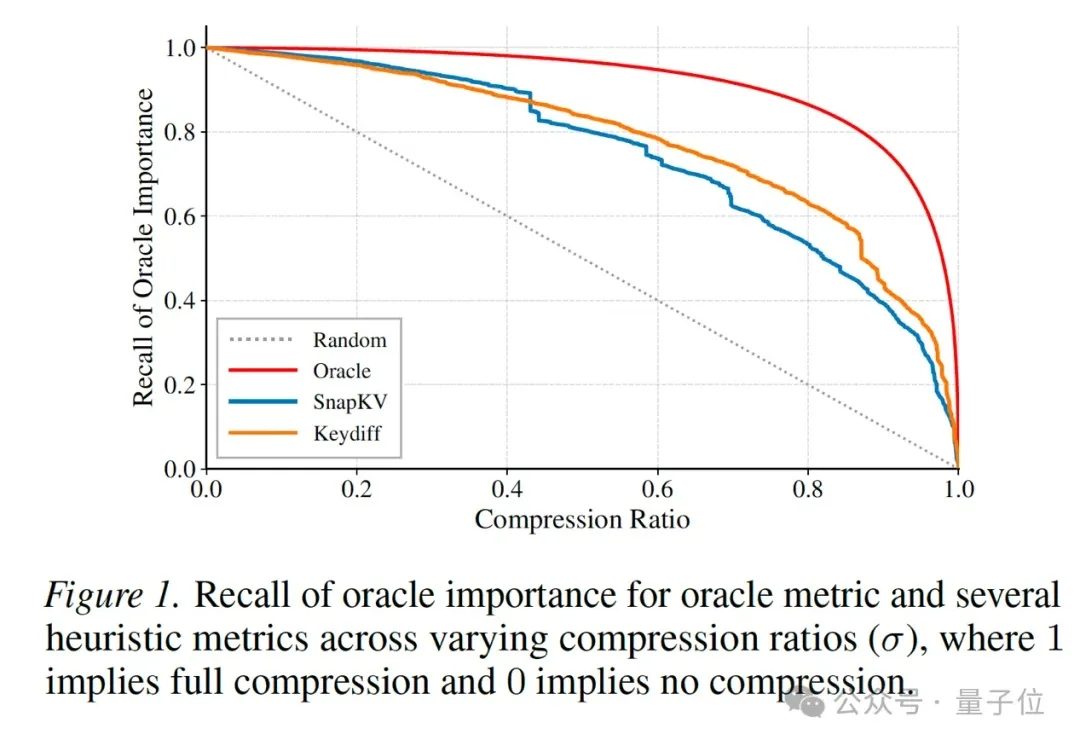
随着大模型长上下文能力快速增长,海量 KV Cache 存储需求急剧增加,各类 KV Cache 压缩方法如雨后春笋般涌现。然而,这些方案在真实场景中的工程落地却常常陷入困境。
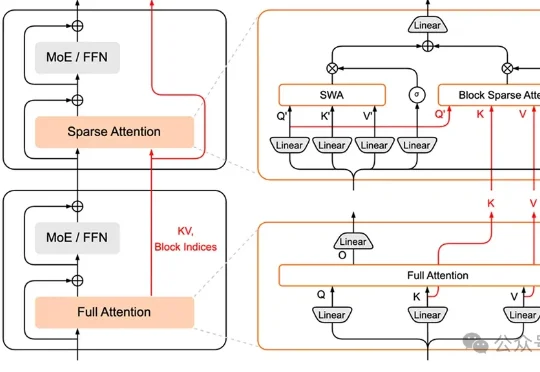
小米MiMo大模型团队,加入AI拜年战场——推出HySparse,一种面向Agent时代的混合稀疏注意力架构。
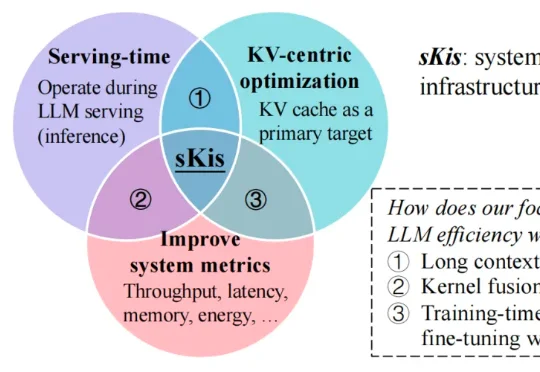
近期,来自墨尔本大学和华中科技大学的研究者们发布了一篇深度综述,从 MLSys 的思维出发,用一套新颖的「时间 - 空间 - 结构」系统行为视角对 KV cache 优化方法进行了系统性梳理与深入分析,并将相关资源整理成了持续维护的 Awesome 资源库,方便研究者与从业人员快速定位与落地。